AI 驱动测试实战用 Dify 生成测试用例
用 Dify 生成测试用例
第 1 讲 · Yoyo本慢 · 搭一个小应用,把需求变成用例
免费的系列课,在本站直接播放,不用登录。视频由 B 站提供。
共 16 讲
从 B 站挑选的公开视频,在本站直接看。十二位作者,各自讲一件具体的事:生成用例、接到自动化,以及给模型做压测。
适合:已经在用大模型写用例或脚本,想先看看别人是怎么做的测试工程师。
共 16 讲
第 1 讲 · Yoyo本慢 · 搭一个小应用,把需求变成用例
第 2 讲 · 任我御风而行 · 从安装到导出一份用例表
第 3 讲 · 清风说测试开发 · 生成之后,人还要看的地方
第 4 讲 · Hyowinner校长 · 拿一条逻辑,看它覆盖得怎么样
第 5 讲 · 严师兄聊AI · 把写测试收成一条命令
第 6 讲 · Raina测试 · 规则写对,生成的结果才稳
第 7 讲 · 向度之桥 · 让 Claude Code 自己点页面
第 8 讲 · 测试避坑君 · 从安装到把一条流程跑起来
第 9 讲 · Zhu的AI日记 · 在 Cursor 里测一个 App
第 10 讲 · 西瓜讲大模型 · 并发上去之后先看什么
第 11 讲 · 小工蚁创始人 · 一个开源的模型压测工具
第 12 讲 · AIGC科技官 · 压测的同时看监控
第 13 讲 · 每日学编程 · 单集标题是 EvalScope 压力测试,讲的是压测,不是评测指标概述。
第 14 讲 · swanmsg · 简介指向 vLLM 项目下的 GuideLLM 仓库,讲部署后的基准测试。
第 15 讲 · 但问智能 · 把需求和 Schema 接进 Agent,让它生成、诊断并修复 API、性能和 UI 测试。
第 16 讲 · Qoder · 通过 Qoder 的实际演示,了解 AI 编程工具如何辅助测试工作提效。
共 45 讲 · 学掌门
一门课讲清 AI 测评和传统测试差在哪,指标、流程、风险和缺陷怎么定级,再用 EvalScope 对接 Langfuse 把一批用例跑起来。视频来自学掌门的公开合集,站点只收测评主线。
适合:做 AI 测试、模型验收或 Agent 上线评审的测试和研发。
共 45 讲
第 1 讲 · 学掌门 · 先分清测评对象和结论,不要把它当成又一轮功能点验收。
第 2 讲 · 学掌门 · 同一条输入,传统测试要确定结果,模型测评要看稳定和可复现。
第 3 讲 · 学掌门 · 先看分错到哪一类,再谈一个总分。
第 4 讲 · 学掌门 · 从数据、指标到结论,按一条能复跑的流程走。
第 5 讲 · 学掌门 · 先分清这门课说的四类对象,再决定分数能不能横比。
第 6 讲 · 学掌门 · 先找出会让整批评测结论失真的点,再比较高低分。
第 7 讲 · 学掌门 · 评测里的问题要能定级,才能进缺陷单,而不是停在感觉。
第 8 讲 · 学掌门 · 单条手测看不出回归,一批用例才看得到。
第 9 讲 · 学掌门 · 只为后面的容器环境。本机已经能跑 Docker 可以跳过。
第 10 讲 · 学掌门 · Langfuse 和 EvalScope 都放在这套容器上。
第 11 讲 · 学掌门 · 每次评测的输入、输出和分数要留痕,不能只剩终端日志。
第 12 讲 · 学掌门 · 用它把数据集和指标接起来,而不是手写一次性脚本。
第 13 讲 · 学掌门 · 跑完要能回看每一条,而不是只拿到一个汇总数。
第 14 讲 · 学掌门 · 把一批用例真正跑起来,看指标而不是看感觉。
第 15 讲 · 学掌门 · 能复跑、能对比、能指出哪条失败,这门课才算走完。
第 16 讲 · 每日学编程 · 单集标题是 EvalScope 概述,只讲这个工具在测什么,不讲后面的压力测试。
第 17 讲 · 前端屎不了 · 简介写了从 Observation、Trace、Session 讲到 Evals、Datasets 和 Metrics。
第 18 讲 · 科罗廖夫的雪松 · 简介里作者用它和 RAGAS 对比,想把上一轮结果拿来做卡点。
第 19 讲 · THUAIR_人机交互研究组 · 简介写的是 Nature 论文:用语义熵检测大语言模型幻觉。
第 20 讲 · 熊二等兵 · 用最终成功率和中间检查点一起看任务完成度,定位长链路 Agent 卡在哪一步。
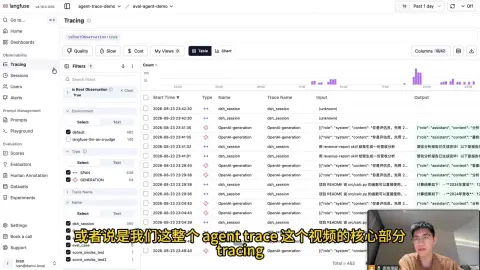
第 21 讲 · 卡比Prover · 先沿执行轨迹看清 Agent 做了什么,再决定在哪些节点设置评测。
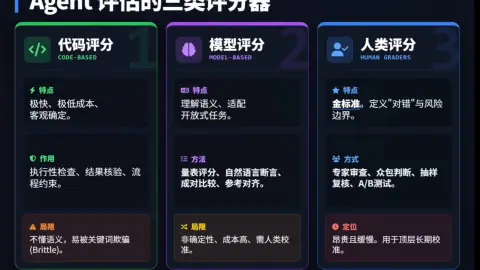
第 22 讲 · 慢学AI · 围绕 Agent 评估设计评分器,把结果判断从主观感觉变成明确规则。
第 23 讲 · 量子菠萝_ · 从 Trace、失败归因和评分器一路做到自动化实验,验证提示词改动是否真的有效。
第 24 讲 · 源语AI-摸鱼字幕君 · 从离线模拟、质量门禁到线上监控,用任务是否真正完成来定义生产级评测闭环。
第 25 讲 · 西瓜讲大模型 · 跟着完整演示串起 Agent 评估流程,建立从开始到收口的整体认识。
第 26 讲 · wanzij177 · 从代码、模型、人工三类 Grader 讲到评测噪音、应试和长任务提前收工的问题。
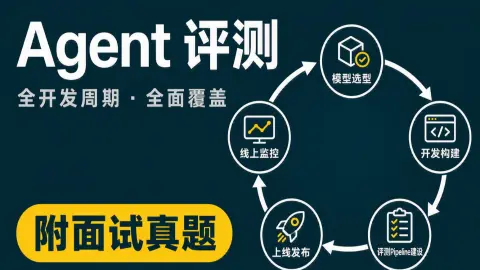
第 27 讲 · 不转到大模型不改名 · 从模型选型、组件与集成测试,到流水线和上线监控,串起一条 Agent 评估线。
第 28 讲 · AI老马啊 · 把 Agent 的评测对象、数据和执行流程组织成可自动运行的体系。
第 29 讲 · AIOps智能运维 · 从模型效果、系统可用、用户采用和业务价值四层拆开评测目标,再用 Golden Set 和工具正确性补齐证据。
第 30 讲 · 慢学AI · 先明确评测为何是 Agent 稳定迭代和规模化的基础。
第 31 讲 · 慢学AI · 把 Agent 结果交给明确的评分器,而不是只凭主观印象判断。
第 32 讲 · 慢学AI · 区分偶尔成功和稳定成功,避免被单次运行结果误导。
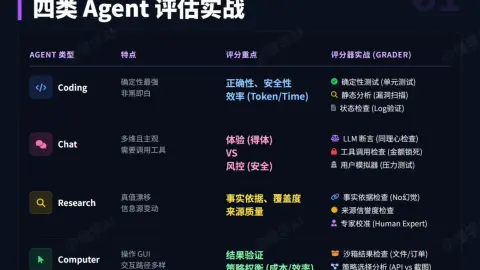
第 33 讲 · 慢学AI · 不同 Agent 的任务形态不同,评分器也不能只套同一套标准。
第 34 讲 · 慢学AI · 把评测对象、数据和评分方式组织成一套可持续运行的体系。
第 35 讲 · 慢学AI · 离线评测之外,还要持续观察上线后的真实运行表现。
第 36 讲 · 高楼_Zee · 从工具定位入手,建立 EvalScope 与大模型评测流程的基础认识。
第 37 讲 · 慢学AI · 按团队技术栈、运行隔离、生产监控和数据合规需求,判断评测工具是自建还是采用现有框架。
第 38 讲 · GPT中英字幕课程资源 · 从有效性、幻觉和偏见入手,把 Agent 评测接入迭代与生产监控。
第 39 讲 · 肖恩君Sean · 从运行轨迹、Langfuse 追踪和模型裁判入手,理解评测如何进入修复闭环。
第 40 讲 · 丸一口 · 沿论文与代码拆解一个专门评估 LLM Agent 能力的框架。
第 41 讲 · ShiianAI · 从数据准备到结果可视化,完整跑一遍 RAG 评估并检查单条样本。
第 42 讲 · 丹哥二号 · 把评测框架用于模型压力测试
第 43 讲 · poyhh · 用指标和测试框架替代凭感觉验收
第 44 讲 · TreeDy1 · 从 Task、Grader、Harness 理解 Agent 评测
第 45 讲 · David鲍曼 · 把 LLM 评测落到 Python 实现
共 11 讲 · 骰子AI
按原分 P 顺序看 RAG 评测指标:相似度、相关性、上下文精确率、召回、忠实度、正确性和方面评价。视频是骰子AI 的公开合集,中间有一集专门讲上下文召回在 RAGAS 里的坑。
适合:已经在做检索增强,想知道回答哪一段站不住的测试和研发。
共 11 讲
第 1 讲 · 骰子AI · 这一集标题是概览,先把后面要拆的指标摆出来。
第 2 讲 · 骰子AI · 分 P 标题是 Answer Similarity,讲答案和参考答案像不像。
第 3 讲 · 骰子AI · 分 P 标题是 Answer Relevance,讲回答是否扣住问题。
第 4 讲 · 骰子AI · 分 P 标题是 Context Precision。
第 5 讲 · 骰子AI · 分 P 标题是 Context Relevance。
第 6 讲 · 骰子AI · 分 P 标题是 context recall。
第 7 讲 · 骰子AI · 分 P 标题写的就是 context recall 在 RAGAS 里的坑。
第 8 讲 · 骰子AI · 分 P 标题是 Faithfulness。
第 9 讲 · 骰子AI · 分 P 标题是 Answer Correctness。
第 10 讲 · 骰子AI · 分 P 标题是 Aspect Critique。
第 11 讲 · 骰子AI · 最后一集标题是总结。
共 2 讲 · OpenMMLab
两集分开的公开课,都来自 OpenMMLab:先讲 OpenCompass 怎么做大模型评测,再讲一次实战。不是同一个 BV,也不是模型排行榜。
适合:要给大模型做公开基准评测、而不是看排行榜的测试和研发。
共 2 讲
第 1 讲 · OpenMMLab · 官方教程这一集讲 OpenCompass 大模型评测,简介里给了教程文档和仓库。
第 2 讲 · OpenMMLab · 贡献者讲的实战课,简介里给了课程文档和作业仓库。
共 5 讲 · 但问智能
用一个真实的视频案例,学习视觉大模型如何读取思维导图、流程图和 UI 界面,生成测试用例并导出结果,串起一条可复用的 AI 测试用例自动化流程。
适合:想把视觉大模型用于测试用例设计,或正在搭建 AI 测试智能体的测试工程师。
共 5 讲
第 1 讲 · 但问智能 · 从思维导图、流程图和 UI 界面出发,走完测试用例生成与导出的完整链路。
第 2 讲 · 但问智能 · 把业务知识接入大模型,让生成的测试用例不只依赖一段临时提示词。
第 3 讲 · 但问智能 · 从生成逻辑到智能体流程,完整实现一套测试用例自动化应用。
第 4 讲 · 但问智能 · 用结构化智能体处理大量需求,把批量生成变成可控制的工程流程。
第 5 讲 · 但问智能 · 把自然语言、UI 理解、Playwright 和可视化报告接起来,执行并调试界面测试。
共 9 讲 · 大云哥讲AI
按 B 站公开合集的 9 个分 P,依次学习 AI 应用评测的基础概念、指标、数据集、评测器,以及 Agent 和 RAG 的评测方法,最后用 LangSmith 跑通评测流程。
适合:正在做 AI 应用、Agent 或 RAG,希望把主观验收变成可复跑评测的测试与研发人员。
共 9 讲
第 1 讲 · 大云哥讲AI · 先建立评测对象、流程和结论的共同框架。
第 2 讲 · 大云哥讲AI · 把想观察的能力拆成可以记录和比较的指标。
第 3 讲 · 大云哥讲AI · 准备一组能支撑重复运行和对比的数据。
第 4 讲 · 大云哥讲AI · 从评测器选择走到一轮实际执行。
第 5 讲 · 大云哥讲AI · 围绕 Agent 的行为和结果,明确该怎样评。
第 6 讲 · 大云哥讲AI · 把检索增强应用的回答质量拆成可评测的问题。
第 7 讲 · 大云哥讲AI · 把前面的指标、数据集和评测器接到 LangSmith。
第 8 讲 · 大云哥讲AI · 对一版 LLM 应用执行完整评测。
第 9 讲 · 大云哥讲AI · 把评测方法落到一版 RAG 应用的实际运行。
共 2 讲 · 森_MS
用一条两 P 的公开实战视频,建立 Agent 项目的指标评测线:从幻觉率、空答率、首轮满意度,到 Token 成本、TTFB 与转人工率,再用真实日志和可复现的指标采集流程验证结果。
适合:正在做 AI Agent 验收、质量分析或上线监控,希望把“效果好不好”拆成可计算指标的测试、研发和产品人员。
共 2 讲
第 1 讲 · 森_MS · 从幻觉率、满意度、响应速度、成本和转人工率入手,把 Agent 效果拆成可计算的指标。
第 2 讲 · 森_MS · 用短补充片段收口同一套 Agent 评测指标实测。